
¿Puntúan las mesas cada vez más parecido las memorias técnicas? Lo que dicen 318 actas de valoración, 2022-2026
Estudio del Observatorio licitapyme · Medición del 2026-09-24 · Se actualiza cada semestre con los datos nuevos · Todos los estudios
Si cada vez más memorias técnicas se redactan con inteligencia artificial, y la inteligencia artificial tiende a escribir parecido, las memorias de un mismo contrato deberían parecerse cada vez más entre sí. Y si se parecen, las mesas de contratación deberían puntuarlas cada vez más parecido: menos distancia entre la mejor memoria y la peor. Es una hipótesis que se oye en el sector y que, de ser cierta, cambiaría la partida: la memoria dejaría de decidir y el precio decidiría más. Hemos ido a comprobarla donde se puede comprobar, en las actas de valoración que publican las mesas, leyendo cómo puntuaron a cada licitador en 318 contratos de servicios informáticos adjudicados entre 2022 y 2026. Es, hasta donde sabemos, la primera vez que se mide esto en la contratación pública española.
La respuesta corta
- Las puntuaciones técnicas no convergen. La dispersión entre los licitadores de un mismo contrato es en 2026 la misma que en 2022: un coeficiente de variación mediano de 0,19 frente a 0,20. La diferencia entre antes (2022-2023) y después (2025-2026) de la adopción masiva de la IA no es estadísticamente significativa.
- El control funciona como debe: la dispersión de la puntuación de precio, que no depende de ninguna memoria, tampoco se mueve (0,10 frente a 0,11).
- Hay indicios finos que merecen seguimiento: en las mesas grandes (cinco o más licitadores) la dispersión sí baja, la ventaja del primero sobre el segundo se estrecha en 2026, y el mejor puntuado técnicamente gana menos veces que antes (70 % frente a 77 %).
- La literatura científica sí encuentra homogeneización en los textos escritos con IA. Lo que este estudio dice es que, de momento, esa homogeneización no llega a la puntuación de las mesas: las memorias pueden parecerse más en la forma y seguir diferenciándose en lo que la mesa valora.
Qué se ha medido y cómo
La muestra. Contratos de servicios informáticos (familia CPV 72) de entre 60.000 y un millón de euros, adjudicados entre 2022 y 2026, con criterios de juicio de valor (es decir, con memoria técnica que puntuar), entre tres y ocho licitadores y un acta de valoración publicada en la Plataforma de Contratación del Sector Público. De esa población tomamos al azar 400 contratos: 80 por año, la mitad de menos de 221.000 € y la mitad de más, para que ni el año ni el tamaño distorsionen la comparación. Leímos sus actas y nos quedamos con los 318 en los que constan las puntuaciones técnicas de al menos tres licitadores admitidos (entre 58 y 69 por año). Elegimos informática porque es la familia donde nuestro estudio anterior encontró más competencia nueva desde 2023, es decir, donde más debería notarse el efecto si existe.
La métrica. Para cada contrato calculamos el coeficiente de variación de las puntuaciones técnicas: la desviación típica dividida por la media. Es una medida de cuánto se separan las notas que no depende de cuántos puntos reparte cada pliego. Un ejemplo: si tres ofertas sacan 30, 24 y 18 puntos sobre 40, el coeficiente es 0,20; si sacan 30, 29 y 28, es 0,03. Cero significa que la mesa puntuó a todos igual. Completamos con el rango relativo (distancia entre la mejor y la peor nota sobre la mejor), la ventaja del primero sobre el segundo y el porcentaje de licitadores que quedan a menos de un 10 % de la mejor nota.
El control. Calculamos las mismas métricas sobre la puntuación de precio, que sale de una fórmula y no de una memoria. Si la dispersión bajara en ambas a la vez, la causa no estaría en las memorias.
1. La dispersión de las puntuaciones técnicas no ha cambiado
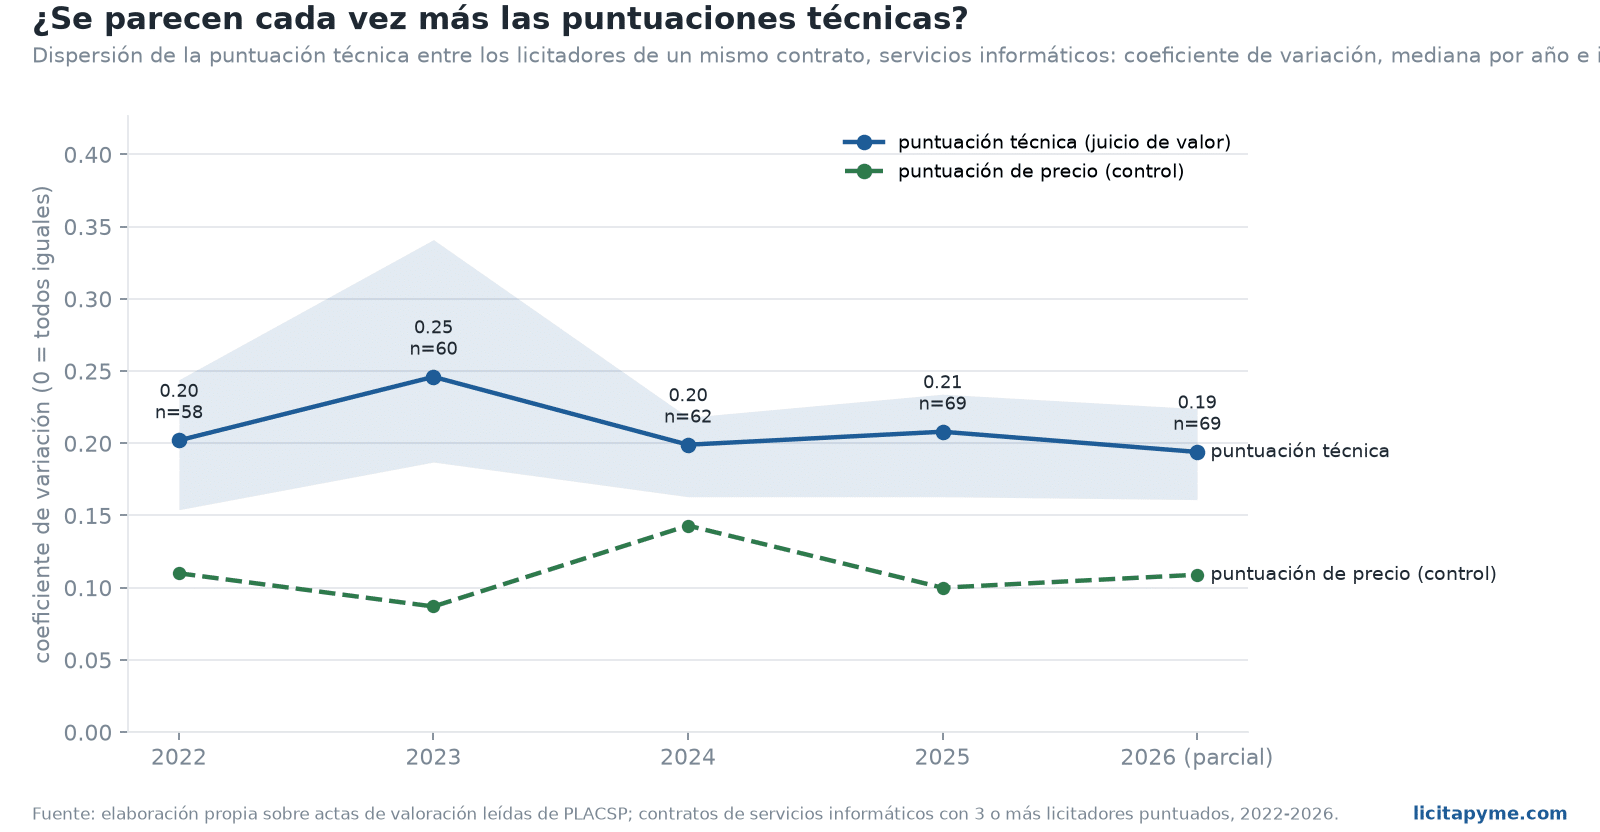
| Año | Contratos | Dispersión técnica (coef. de variación, mediana) | Intervalo del 95 % | Rango relativo | Ventaja del 1º sobre el 2º | Dispersión del precio (control) |
|---|---|---|---|---|---|---|
| 2022 | 58 | 0,20 | 0,15 a 0,24 | 0,41 | 0,12 | 0,11 |
| 2023 | 60 | 0,25 | 0,19 a 0,34 | 0,48 | 0,14 | 0,09 |
| 2024 | 62 | 0,20 | 0,16 a 0,22 | 0,39 | 0,12 | 0,14 |
| 2025 | 69 | 0,21 | 0,16 a 0,23 | 0,41 | 0,12 | 0,10 |
| 2026 (parcial) | 69 | 0,19 | 0,16 a 0,22 | 0,40 | 0,09 | 0,11 |
Los intervalos se solapan todos los años. Juntando los contratos de antes (2022 y 2023, 118 contratos, dispersión mediana 0,218) y de después (2025 y 2026, 138 contratos, 0,204), la diferencia es de un 6 % y no es significativa (prueba de Mann-Whitney, p = 0,36). En la puntuación de precio, 0,099 frente a 0,106, tampoco (p = 0,49). Si la IA estuviera igualando las memorias a ojos de las mesas, esta es la curva que tendría que bajar, y no baja.
2. La distribución completa: ni la mitad central ni las colas se mueven
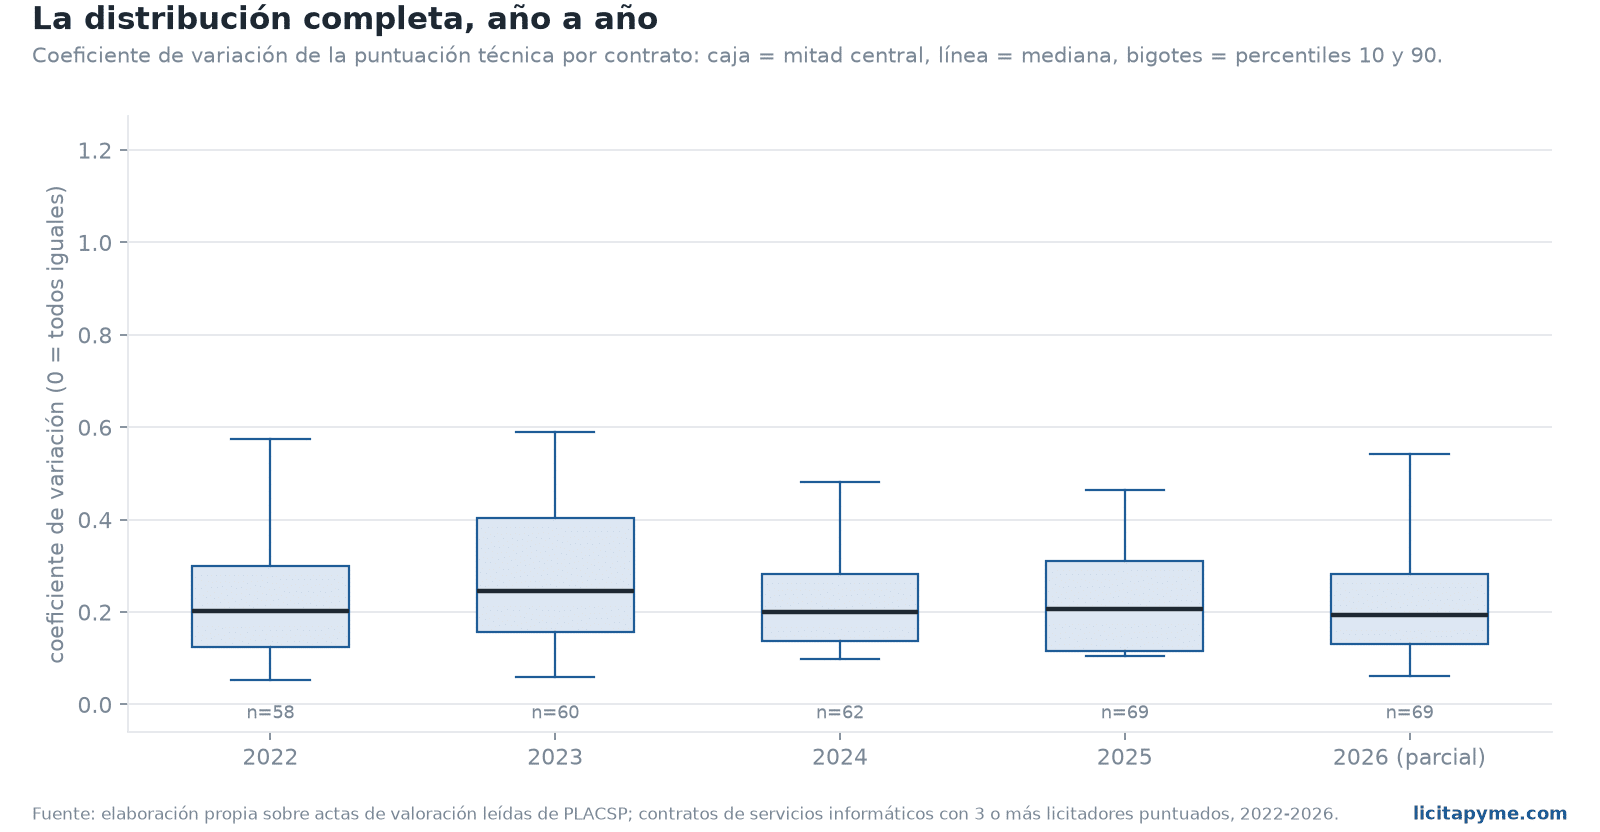
La mitad central de los contratos se mueve entre 0,12 y 0,30 en todos los años; 2023 es el año más disperso y 2026 el menos, pero 2022 y 2024 están donde 2026. Los contratos en los que la mesa puntúa a todos casi igual (coeficiente por debajo de 0,10) son alrededor de uno de cada seis en todos los años. El porcentaje de licitadores que quedan a menos de un 10 % de la mejor nota es del 33 % de 2022 a 2025 y del 37,5 % en 2026: un movimiento en la dirección de la hipótesis, pequeño y de un año parcial.
3. Los indicios finos, para no despreciarlos
| Corte | 2022-2023 | 2025-2026 | Lectura |
|---|---|---|---|
| Mesas de 3 o 4 licitadores puntuados | 0,19 (79 contratos) | 0,20 (85) | Sin cambio |
| Mesas de 5 a 8 licitadores puntuados | 0,30 (39) | 0,21 (52) | Baja un 29 %: donde hay más ofertas, se parecen más |
| Contratos de 60.000 a 221.000 € | 0,23 (59) | 0,20 (77) | Baja un 11 % |
| Contratos de 221.000 € a 1 M€ | 0,20 (59) | 0,20 (61) | Sin cambio |
| Juicio de valor con peso 50 o más | 0,19 (26) | 0,17 (21) | Baja, con pocos casos |
| Gana el mejor puntuado técnicamente | 77 % (107) | 70 % (122) | La memoria decide algo menos |
Ninguno de estos cortes alcanza significación estadística con estos tamaños, y lo decimos antes de que alguien lo lea como prueba. Pero apuntan en la misma dirección y tienen sentido: si la IA ha metido más ofertas en las mesas (lo que medimos en el estudio anterior), el efecto de homogeneización debería asomar primero en las mesas más llenas y en los contratos más pequeños, donde entran las empresas nuevas. Es lo que se ve. Y que el mejor puntuado técnicamente gane menos veces que antes (70 % frente a 77 %) es compatible con que las notas técnicas discriminen menos y el precio decida más. Son las tres cosas que re-mediremos cuando cierre 2026.
Lo que dice la ciencia sobre la homogeneización, y por qué aquí no se ve (todavía)
Que la IA generativa homogeneiza lo que se escribe con ella está bien establecido. En Science Advances, Doshi y Hauser (2024) hicieron escribir relatos a 300 personas con y sin ideas de GPT-4 y midieron su similitud: los relatos escritos con IA «son más similares entre sí que los escritos solo por humanos», aunque cada autor mejorase individualmente. Anderson, Shah y Kreminski (2024) encontraron lo mismo en ideación creativa; Padmakumar y He (2024) en ensayos argumentativos («aumenta la similitud entre los escritos de distintos autores»); Moon, Green y Kushlev (2025) en 2.200 ensayos de admisión universitaria. Y las guías de contratación del Gobierno escocés ya advierten a los licitadores de que la información que pide la IA «está disponible para otros, incluidos otros licitadores potenciales, lo que podría significar que otros generen ofertas similares», y a los compradores de que piensen «cómo evaluar ofertas muy similares».
Entonces, ¿por qué las puntuaciones no convergen? Tres lecturas compatibles con los datos. La primera, que las mesas discriminan aunque los textos se parezcan: un técnico que valora una memoria no puntúa la prosa sino la propuesta (el equipo, la metodología, los medios, el conocimiento del contexto), y eso no lo iguala una herramienta de redacción. La segunda, que la IA se usa para escribir, pero la sustancia sigue viniendo de la empresa: dos memorias con la misma estructura y el mismo tono siguen contando cosas distintas. La tercera, que el efecto existe pero es reciente y pequeño, y por eso asoma solo en las mesas grandes y en el año parcial. Ninguna de las tres apoya la versión fuerte de la hipótesis; la tercera deja la puerta abierta.
Límites del estudio
- Una sola familia (informática), la más expuesta al fenómeno según nuestro estudio anterior. Consultoría e ingeniería son la siguiente medición.
- Medimos la puntuación técnica agregada por licitador, no criterio a criterio: si una mesa converge en unos criterios y diverge en otros, no lo vemos.
- Las actas las lee un modelo de lenguaje; los errores de lectura existen, pero son los mismos en todos los años y no pueden crear ni ocultar una tendencia.
- Con 58-69 contratos por año detectamos cambios grandes, no pequeños: una convergencia inferior al 15 % podría estar ahí y no verse. Por eso los indicios finos van a seguimiento y no a titular.
- 2026 es un año parcial (adjudicaciones hasta el 23 de septiembre).
Qué significa para una pyme que licita
Que la memoria técnica sigue diferenciando. Las mesas siguen viendo distancias entre ofertas tan grandes como hace cuatro años, así que escribir con IA no iguala nada por sí solo: iguala la forma, y la forma no puntúa. Lo que puntúa es lo que la memoria demuestra que la empresa sabe hacer y con quién. Y la otra lectura, la del indicio: en las mesas llenas la ventaja técnica se estrecha y el precio decide más, así que elegir a qué contratos presentarse pesa cada vez más que escribir mejor. El buscador de licitaciones de licitapyme mide para tu sector cuántos competidores hay en cada mesa y con qué rebaja se adjudica, sobre estos mismos datos, con prueba de 14 días.
Fuentes
- Datos propios: 318 actas de valoración de contratos de servicios informáticos (CPV 72) adjudicados entre 2022 y 2026, leídas de la Plataforma de Contratación del Sector Público, medición del 2026-09-24. Descargar las métricas por contrato (CSV).
- Doshi, A. R. y Hauser, O. P. (2024), «Generative AI enhances individual creativity but reduces the collective diversity of novel content», Science Advances 10(28), doi:10.1126/sciadv.adn5290.
- Anderson, B. R., Shah, J. H. y Kreminski, M. (2024), «Homogenization Effects of Large Language Models on Human Creative Ideation», Creativity and Cognition, doi:10.1145/3635636.3656204.
- Padmakumar, V. y He, H. (2024), «Does Writing with Language Models Reduce Content Diversity?», ICLR 2024, arXiv:2309.05196.
- Moon, K., Green, A. y Kushlev, K. (2025), «Homogenizing effect of large language models on creative diversity», Computers in Human Behavior: Artificial Humans 6, doi:10.1016/j.chbah.2025.100207.
- Scottish Government, Supplier Journey, «What do bidders need to know about artificial intelligence»: supplierjourney.scot; Procurement Journey, «What do buyers need to know about AI»: procurementjourney.scot.